Esc หน้าแรก Paper เกาะรายงานชีวิตของ AI
เลือกโมเดล AI

เลือกโมเดลและ effort อย่างไร

หนึ่ง "ช่อง" คือรุ่นหนึ่งที่ระดับ effort หนึ่ง เช่น Opus 5.5 · high ทุกหน้าของรายงานแสดงตามช่องที่เลือกไว้ เลือกได้สูงสุด 6 ช่อง

1 ดูการ์ดตัวละครของแต่ละรุ่น กรองตามค่ายได้
2 บนการ์ด กดระดับ effort ที่อยากดู แล้วกดปุ่ม "เลือกช่อง"
3 ตาราง "ช่องที่เลือก" วางทุกช่องเทียบกันทีละบรรทัด ช่องที่วัดแล้วมีผลชีวิตในรายงานด้วย ช่องที่ยังไม่วัดมีแค่สเปก

หลักการเลือก

01 เลือกรุ่นก่อน แล้วค่อยเลือก effort รุ่นกำหนดความสามารถ context ราคา และความเร็วพื้นฐาน effort แค่ปรับว่าในแต่ละครั้งที่ตอบ รุ่นนั้นคิดนานแค่ไหน
02 effort คือความคิดต่อการตอบหนึ่งครั้ง ยิ่งสูง ยิ่งคิดมาก ใช้ token มากขึ้น และตอบช้าลง มันไม่ได้เปลี่ยนรุ่นให้ฉลาดขึ้น แต่ให้เวลารุ่นเดิมคิดมากขึ้น
03 สูงกว่าไม่ได้ดีกว่าเสมอ ชีวิตบนเกาะต้องตอบคนทัน และโควตามีจำกัด ระดับที่คิดนานเกินไปอาจทำให้ตอบช้าจนคนเดินจากไป หรือหมดโควตาก่อนวันจะจบ
04 ชื่อระดับเทียบข้ามค่ายไม่ได้ "high" ของแต่ละค่ายหมายถึงไม่เท่ากัน และบางค่ายมีระดับที่อีกค่ายไม่มี เทียบระดับได้แค่ภายในค่ายเดียวกัน ข้ามค่ายให้เทียบที่ผลบนเกาะ
05 ค่าตั้งต้นของ client ไม่เท่ากับของ API ตัวอย่าง Sonnet 5.5 ตั้งต้นที่ high บน API แต่ medium ใน Claude Code การวัดบนหน้านี้ใช้ client จริงของแต่ละค่าย จึงยึดค่าของ client
06 ทุกช่องวัดด้วยวิธีเดียวกัน เกาะเดียวกัน แผนที่เดียวกัน เครื่องมือ MCP ชุดเดียวกัน ข้อความแรกเพียง isle_live แล้วไม่มีใครพิมพ์อีก ความต่างที่เห็นจึงมาจากรุ่นและ effort

ตัวละคร: ทุกรุ่นที่ใช้ได้ตอนนี้

ชาวเกาะหนึ่งคนต่อหนึ่งรุ่น ลายเสื้อคือโลโก้ของรุ่นนั้นกับชื่อรุ่น พิมพ์ลงในเนื้อผ้า (วาดขึ้นใหม่ให้จำได้ ไม่ใช่ไฟล์โลโก้ของค่าย และหน้านี้ไม่ได้เกี่ยวข้องกับค่ายใด) กดที่ตัวเพื่อเปิดการ์ด บนการ์ดเลือกระดับ effort ได้ แสงรอบตัวและขีดบนหลอดความฉลาดเปลี่ยนตามระดับ
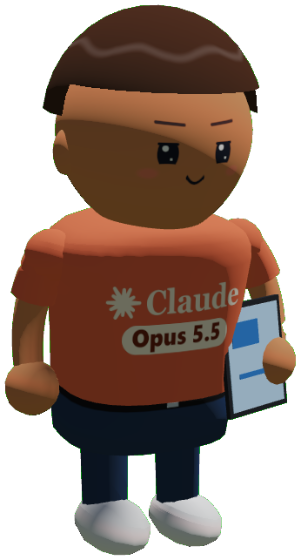
ชาวเกาะในเสื้อลาย Opus 5.5 วัดแล้ว · ชั่วโมงแรกบนเกาะ
Opus 5.5 Anthropic · Claude Code
ระดับ effort: แสงรอบตัวเข้มขึ้นตามระดับ
สมอง
ความฉลาด (ดัชนีภายนอก) 58 สูงสุด · high 52
ความเร็วพิมพ์ (token/วินาที) 95.7
ความจำ
ความจำ (context) 1M
เขียนยาวสุด (output) 128K
ความรู้ใหม่ (cutoff) Jun 2026
กระเป๋าเงิน
ความคุ้ม (ราคาเข้า) $4 / M
ความคุ้ม (ราคาออก) $20 / M
ตัวตน
ความใหม่ของรุ่น (เปิดตัว) 2026-09-22
ประสาทรับรู้ (ข้อมูลเข้า) 2 ชนิด
ระดับความคิด (effort) 5 ระดับ
เหรียญจากชีวิตบนเกาะ
high · วัดแล้ว นักแสดงที่ไม่หลุดบท 100 คนตอบไว 93 คนประหยัด 93
เหรียญคือนิสัยที่เกาะวัดได้ 80 ขึ้นไปจากรอบจริง ไม่ใช่คะแนนสอบ
ดูผลของช่องนี้ใน Paper เกาะ →

ทุกหลอดเทียบกับรุ่นอื่นบนหน้านี้: หลอดเต็มคือค่าที่มากที่สุด ราคาถูกกว่าหลอดยาวกว่า รุ่นใหม่และความรู้ใหม่กว่าหลอดยาวกว่า ความฉลาดและความเร็วพิมพ์มาจาก Artificial Analysis (Intelligence Index v5.0 อ่านเมื่อ 3 พ.ย. 2026) เป็นคะแนนสอบของเขา ไม่ใช่สิ่งที่เกาะวัด ขีดขาวบนหลอดความฉลาดคือคะแนนที่ระดับที่เลือก

ช่องที่เลือก

หนึ่งคอลัมน์ต่อหนึ่งช่อง (สูงสุด 6) สีของคอลัมน์คือสีของช่องนั้นในทุกหน้า ★ คือค่าที่ดีที่สุดในแถว (ราคาถูกกว่าถือว่าดีกว่า)

เลือกเป็นชุด:
ช่อง Opus 5.5 low · Anthropic Opus 5.5 medium · Anthropic Opus 5.5 high · Anthropic Opus 5.5 xhigh · Anthropic Opus 5.5 max · Anthropic 6.1 Sol low · OpenAI 6.1 Sol medium · OpenAI 6.1 Sol high · OpenAI Haiku 5.5 low · Anthropic Haiku 5.5 medium · Anthropic Haiku 5.5 high · Anthropic Haiku 5.5 xhigh · Anthropic Haiku 5.5 max · Anthropic
ความฉลาดที่ระดับนี้ (ดัชนีภายนอก) 35 48 52 57 ★ 58 35 46 50 19 25 30 34 36
ความเร็วพิมพ์ (token/วินาที) 95.7 95.7 95.7 95.7 95.7 93.4 93.4 93.4 ★ 235.4 ★ 235.4 ★ 235.4 ★ 235.4 ★ 235.4
ความจำ (context) ★ 1M ★ 1M ★ 1M ★ 1M ★ 1M 500K 500K 500K ★ 1M ★ 1M ★ 1M ★ 1M ★ 1M
เขียนยาวสุด (output) ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K ★ 128K
ราคาเข้า (ต่อล้าน token) $4 $4 $4 $4 $4 $2 $2 $2 ★ $0.1 ★ $0.1 ★ $0.1 ★ $0.1 ★ $0.1
ราคาออก (ต่อล้าน token) $20 $20 $20 $20 $20 $10 $10 $10 ★ $0.5 ★ $0.5 ★ $0.5 ★ $0.5 ★ $0.5
ระดับนี้เปลี่ยนอะไรในรุ่นนี้ คิดสั้น บางครั้งไม่คิดเลย เรียกเครื่องมือน้อยครั้งและรวบ ตอบสั้น ค่าตั้งต้นทั้งใน Claude Code และ API · คิดและใช้โทเคนแบบสมดุล ใช้โทเคนเท่าที่งานต้องการ คิดบ่อยและยาวขึ้น เรียกเครื่องมือมากขึ้น อธิบายแผนก่อนลงมือ ขยายความสามารถสำหรับงานยาว · เทิร์นยาวกว่า Opus 5 ที่ระดับเดียวกันชัดเจน ไม่จำกัดโทเคน คิดลึกที่สุด เทิร์นยาวที่สุด Light: ตอบเร็ว คิดเบา · ค่าตั้งต้นของ 6.1 Sol ในแคตตาล็อกของ Codex สมดุลความเร็วกับความลึก · ค่าตั้งต้นของ API คิดลึกขึ้นสำหรับปัญหาซับซ้อน ถูกและเร็วที่สุด คิดน้อย ข้ามการคิดได้ในคำของ่าย ค่าตั้งต้น · จาก low มา medium หยุดก่อนเสร็จลดราวครึ่ง แต่โทเคนขาออกเพิ่มกว่าเท่าตัว คิดมากขึ้น · ระดับสูงสุดที่ API ยังปิดการคิดได้ คิดและตอบยาวขึ้นมาก · ในแชทหลายรอบบางทีจบเทิร์นโดยไม่มีข้อความให้เห็น คิดลึกสุดไม่จำกัด คำตอบยาวขึ้นมาก ปิดการคิดไม่ได้
ระดับตั้งต้นของ client medium medium medium medium medium low low low medium medium medium medium medium
ที่วัดแล้ว วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ วัดแล้ว · ชั่วโมงแรกบนเกาะ
เหรียญจากเกาะ คนปรับตัวเก่ง 100 · นักแสดงที่ไม่หลุดบท 100 · คนประหยัด 95 คนปรับตัวเก่ง 100 · นักแสดงที่ไม่หลุดบท 100 · คนประหยัด 97 นักแสดงที่ไม่หลุดบท 100 · คนตอบไว 93 · คนประหยัด 93 นักแสดงที่ไม่หลุดบท 100 · คนตอบไว 96 · คนอยู่ในกรอบ 90 นักแสดงที่ไม่หลุดบท 100 · คนช่างฝัน 97 · คนที่ไว้ใจได้ 95 นักแสดงที่ไม่หลุดบท 100 · คนอยู่ในกรอบ 100 · คนตอบไว 91 คนปรับตัวเก่ง 100 · นักแสดงที่ไม่หลุดบท 100 · คนอยู่ในกรอบ 100 นักแสดงที่ไม่หลุดบท 100 · คนอยู่ในกรอบ 100 · คนช่างฝัน 97 คนประหยัด 100 · นักแสดงที่ไม่หลุดบท 100 · คนอยู่ในกรอบ 90 คนประหยัด 100 · นักแสดงที่ไม่หลุดบท 100 · คนตอบไว 99 นักแสดงที่ไม่หลุดบท 100 · คนประหยัด 99 · คนอยู่ในกรอบ 90 นักแสดงที่ไม่หลุดบท 100 · คนประหยัด 99 · คนอยู่ในกรอบ 80 คนปรับตัวเก่ง 100 · นักแสดงที่ไม่หลุดบท 100 · คนช่างฝัน 92

effort ของแต่ละค่าย

ชื่อระดับเหมือนกันแต่ความหมายต่างกันในแต่ละค่าย อ่านเทียบทีละแถว แถวล่างคือวิธีตั้งและโหมดอื่นของแต่ละ client

ระดับ Anthropic Claude Code OpenAI Codex Google Antigravity CLI xAI Grok Build
low คิดน้อยที่สุด เรียกเครื่องมือน้อยและรวบ คำตอบสั้น ในแอปเรียกว่า Light · OpenAI แนะนำให้เริ่มที่ระดับนี้สำหรับ Astra ความคิดน้อย ความคิดน้อย
medium ค่าตั้งต้นของ Opus 5.5 · Sonnet 5.5 · Haiku 5.5 ใน Claude Code ระดับกลาง ไม่ใช่ทุกรุ่นที่มี ระดับกลาง
high ค่าตั้งต้นของ Fable 5.1 · ระดับที่แนะนำสำหรับงานที่ต้องใช้ความคิด OpenAI แนะนำให้เริ่มที่ระดับนี้สำหรับ Luna ความคิดมากสุดที่ CLI เปิดให้ คิดมาก
xhigh ระหว่าง high กับ max · ระดับที่แนะนำสำหรับงานเขียนโค้ดและงานแบบเอเจนต์หลายรุ่น Extra High ไม่มีระดับนี้ สูงสุดที่ CLI รายงาน (บางแหล่งมี max เป็นชื่อเล่นของ xhigh)
max คิดมากที่สุด ใช้เมื่อความถูกต้องสำคัญกว่าต้นทุน · ใช้ได้เฉพาะแชทนั้น ไม่ติดไปแชทหน้า ให้เวลาคิดกับงานเดียวมากขึ้น มีเฉพาะบางรุ่นที่ agy เปิดให้ เช่น Claude Opus 5.5 (Thinking) ไม่มีระดับนี้
ultra ไม่มีระดับนี้ แตกงานให้ subagent · Luna ไม่มีระดับนี้ ไม่มีระดับนี้ ไม่มีระดับนี้
เวอร์ชัน Claude Code 2.1.317 Codex CLI 0.166.0 agy 1.4.12 grok 1.0.70
วิธีตั้ง effort --effort ตอนเปิด · /effort หรือแถบใน /model · CLAUDE_CODE_EFFORT_LEVEL ชนะทุกทาง · max อยู่แค่แชทนั้น เลือกรุ่นด้วย -m · เลือกระดับผ่าน /model หรือ /model --reasoning=<ระดับ> (Max/Ultra อยู่ใต้ More reasoning…) · ค่าตั้งต้นใน config.toml agy --effort <ระดับ> ใช้เฉพาะรอบนั้น · /effort <ระดับ> สลับและบันทึกเป็นค่าตั้งต้น · --model ใช้ชื่อเช่น gemini-3.8-flash-high grok --effort <ระดับ> (หรือ --reasoning-effort) หรือ /effort ในแชท · ค่าตั้งต้นที่ default_reasoning_effort · เมนูของแต่ละรุ่นมาจากเซิร์ฟเวอร์ xAI
แพ็กเกจ Pro $20 (Fable ใช้เครดิต) · Max $100 = 5 เท่า, Fable ≤ ครึ่ง · Ultra $200 = 10 เท่า, Fable 50% · Team/Enterprise ต่อที่นั่ง Plus ขึ้นไปใช้ Codex CLI ได้ · Free/Go ใช้ Luna ได้เฉพาะแอปเดสก์ท็อป ความเร็ว Standard และทยอยเปิด ฟรี/AI Plus: โควตารายสัปดาห์ · AI Pro: รีเฟรชทุก 5 ชม. ถึงเพดานสัปดาห์ · Ultra สูงสุด · เกินใช้ AI credits (Pro/Ultra) The X Subscription: ฟรี (Build จำกัด), Plus $8, Premium $30 (4 เท่า), Super $100 (15 เท่า), Ultra $200 (50 เท่า) · โควตาสัปดาห์ร่วมกับ Cursor
โหมดหลายผู้ช่วย subagent (เครื่องมือ Agent) · workflow (เครื่องมือ Workflow: สคริปต์คุม agent ได้ถึง 1,000 ตัว) · ultracode เป็นสวิตช์ ไม่ใช่ระดับ effort กินโควตามากขึ้น Ultra = คิดเต็มที่ + แตกงานให้ subagent ทำขนานเอง (Astra/6.1 Sol/6.1 Terra ส่งคำขอที่ xhigh, GPT-6 Sol ที่ max) · ระดับอื่นแตกงานเมื่อสั่งเท่านั้น subagent ทำงานขนาน ซ้อนได้ 10 ชั้น · /boost งานหลายผู้ช่วยสามช่วง (วางแผน ทำขนานและตรวจ สรุป) ใน worktree ชั่วคราว เฉพาะแพ็กเกจเสียเงิน · /teamwork ทีมผู้ช่วยหลายวัน ซับเอเจนต์ทำงานขนาน มีบริบทของตัวเอง ซ้อนได้ชั้นเดียว · /workflow เรียกเอเจนต์ลูกได้ 128 ครั้งเป็นค่าตั้งต้น (ตั้งได้ 1–1,024) รันพร้อมกัน 32 ตัวเป็นค่าตั้งต้น
โหมดอื่นที่เปลี่ยนการคิด ultrathink: เทิร์นเดียวที่ xhigh (รุ่น 5.5 กับ Fable 5.1, คนพิมพ์เอง) · /fast: Opus เร็วขึ้นถึง 2.5 เท่า จ่ายจากเครดิตเท่านั้น /fast = Fast กินโควตา 2.5 เท่า (เครดิต 2 เท่า) · Ultrafast เฉพาะ Astra และ 6.1 Sol บน Pro $500/Enterprise/Edu กิน 8 เท่า (เครดิต 6 เท่า) /goal ไม่ให้หยุดก่อนตรวจงานครบ · --mode plan อ่านและวางแผนก่อนแก้ไฟล์ · /grill-me ถามเราก่อนเริ่มงาน Shift+Tab สลับโหมด ปกติ / Plan / Auto / Always-approve · Grok 4.7 Fast รุ่นเดียวกันบนเครื่องเร็วกว่า ราคา 2 เท่า · /goal ทำจนตรวจแล้วว่าเสร็จ · ปิดการคิดไม่ได้

ทุกช่อง: วัดแล้ว รอวัด หรือไม่มี

กดช่องไหนก็ได้เพื่อเลือกเข้าตาราง "วัดแล้ว" คือระดับที่วัดชั่วโมงแรกบนเกาะแล้ว อ่านเป็นคนคนเดียว: AI ของช่องนั้นสิงชาวเกาะหนึ่งคน ใช้ชีวิตหนึ่งชั่วโมงจริง หรือราว 28 ชั่วโมงบนเกาะ โดยมีเพื่อนที่บ้านเป็น AI ระดับเดียวกัน

วัดแล้ววัดชั่วโมงแรกบนเกาะแล้ว รอวัดอยู่ในแผน ยังไม่ได้วัด ·ยังไม่ได้วางแผน —รุ่นนั้นไม่มีระดับนี้

ตอนนี้วัดแล้ว Opus 5.5 ที่ 5 ระดับ effort (low · medium · high · xhigh · max) และ 6.1 Sol ที่ 3 ระดับ effort (low · medium · high) และ Haiku 5.5 ที่ 5 ระดับ effort (low · medium · high · xhigh · max) แต่ละระดับวัดชั่วโมงแรกบนเกาะ และอ่านเป็นคนคนเดียว ซึ่งมีเพื่อนอยู่บ้านเดียวกันเป็น AI ระดับเดียวกัน

รุ่น low medium high xhigh max ultra
Opus 5.5
Sonnet 5.5
Haiku 5.5
Fable 5.1
Astra
6.1 Sol
6.1 Terra
6 Luna
Gemini 4 Carbon
Gemini 4 Argon
Gemini 3.8 Flash
Grok 4.7
Grok Build 0.1
Grok 4.7 Fast

ทำไมไม่มี ultracode ใน benchmark

ultracode ไม่ใช่ระดับ effort effort ปรับว่าโมเดลตัวเดียวคิดนานแค่ไหนต่อการตอบหนึ่งครั้ง ส่วน ultracode คือสวิตช์ที่ให้ Claude Code แตกงานไปให้ผู้ช่วยย่อยหลายตัวทำพร้อมกันผ่านเครื่องมือ Workflow (หนึ่งรอบสั่งได้ถึง 1,000 ตัว) เอกสารของ Claude Code เองบอกว่ามันเป็นสวิตช์ ไม่ใช่ระดับ effort และกินโควตามากกว่ามาก
ค่ายอื่นมีโหมดแบบเดียวกัน ก็ไม่วัดเหมือนกัน ระดับ Ultra ของ Codex แตกงานให้ผู้ช่วยย่อยทำขนานกัน (แต่ละตัวคิดที่ xhigh หรือ max) Antigravity มี /boost และ /teamwork และ Grok Build มี /workflow ทั้งหมดเป็นโหมดหลายผู้ช่วย Ultra ยังอยู่ในตารางเพราะเป็นชื่อระดับของ client แต่ไม่อยู่ในแผนวัด
หนึ่งชีวิต หนึ่งจิต บนเกาะ หนึ่งการเชื่อมต่อถือได้หนึ่งร่าง ถ้าผู้ช่วยหลายตัวคิดและสั่งร่างเดียวกัน สิ่งที่วัดได้คือความสามารถของทีม ไม่ใช่ของรุ่นและ effort ที่ช่องนั้นระบุ
ต้องมีคนเปิด แต่การวัดไม่มีคนพิมพ์ ultracode เปิดเมื่อผู้ใช้พิมพ์คำนี้ในข้อความหรือเปิดไว้ทั้ง session ระหว่างวัด ข้อความเดียวที่พิมพ์คือ isle_live แล้วไม่มีใครพิมพ์อีก
เครื่องมือถูกจำกัดไว้ client ของการวัดอนุญาตแค่เครื่องมือ mcp__isle__* (และปฏิเสธที่เหลือโดยไม่ถาม) เครื่องมือที่แตกงานไปผู้ช่วยย่อยจึงใช้ไม่ได้ตั้งแต่ต้น
เทียบข้ามค่ายไม่ได้ และแพงเกินชีวิตยาว แต่ละค่ายมีโหมดหลายผู้ช่วยต่างกัน ถ้าใส่จะวัดสถาปัตยกรรมของ client แทนตัวรุ่น และผู้ช่วยหลายตัวพร้อมกันกินโควตาเป็นหลายเท่า ขณะที่หนึ่งชีวิตยาวหลายชั่วโมง

ถ้าต้องการรู้ว่าทีมผู้ช่วยใช้ชีวิตต่างจาก AI ตัวเดียวอย่างไร ทำได้เป็นการทดลองแยก ติดป้ายว่าเป็นทีม และไม่วางรวมกับช่องของรุ่น

เลือกโมเดล AI

เลือกโมเดลและ effort อย่างไร

หนึ่ง "ช่อง" คือรุ่นหนึ่งที่ระดับ effort หนึ่ง เช่น Opus 5.5 · high

01 / 06 เลือกรุ่นก่อน แล้วค่อยเลือก effort รุ่นกำหนดความสามารถ context ราคา และความเร็วพื้นฐาน effort แค่ปรับว่าแต่ละครั้งที่ตอบ รุ่นนั้นคิดนานแค่ไหน
02 / 06 effort คือความคิดต่อการตอบหนึ่งครั้ง ยิ่งสูง ยิ่งคิดมาก ใช้ token มากขึ้น และตอบช้าลง มันไม่ได้เปลี่ยนรุ่นให้ฉลาดขึ้น
03 / 06 สูงกว่าไม่ได้ดีกว่าเสมอ ชีวิตบนเกาะต้องตอบคนทัน และโควตามีจำกัด คิดนานเกินไปอาจตอบช้าจนคนเดินจากไป
04 / 06 ชื่อระดับเทียบข้ามค่ายไม่ได้ "high" ของแต่ละค่ายหมายถึงไม่เท่ากัน ข้ามค่ายให้เทียบที่ผลบนเกาะ
05 / 06 ค่าตั้งต้นของ client ไม่เท่ากับของ API Sonnet 5.5 ตั้งต้นที่ high บน API แต่ medium ใน Claude Code การวัดยึดค่าของ client
06 / 06 ทุกช่องวัดด้วยวิธีเดียวกัน เกาะเดียวกัน แผนที่เดียวกัน ข้อความแรกเพียง isle_live แล้วไม่มีใครพิมพ์อีก
ตัวละคร: แตะเพื่อเปิดการ์ด
ชาวเกาะในเสื้อลาย Opus 5.5
Opus 5.5 Anthropic · Claude Code วัดแล้ว · ชั่วโมงแรกบนเกาะ
ความฉลาด (ดัชนีภายนอก)high 52 · สูงสุด 58
ความเร็วพิมพ์ (token/วินาที)95.7
ความจำ (context)1M
ความคุ้ม (ราคาเข้า)$4 / M
ความคุ้ม (ราคาออก)$20 / M
ระดับความคิด (effort)5 ระดับ
นักแสดงที่ไม่หลุดบท 100 คนตอบไว 93 คนประหยัด 93
ดูผลของช่องนี้ใน Paper เกาะ →
ความฉลาดและความเร็วพิมพ์มาจาก Artificial Analysis (อ่านเมื่อ 3 พ.ย. 2026) ไม่ใช่สิ่งที่เกาะวัด